技术与效率
OpenAI 公开了一批数学成果,so did I
机器几小时就填完了一张数学纪录表,我写文章的精力却主要用在,如何让字里行间有我自己的温度。
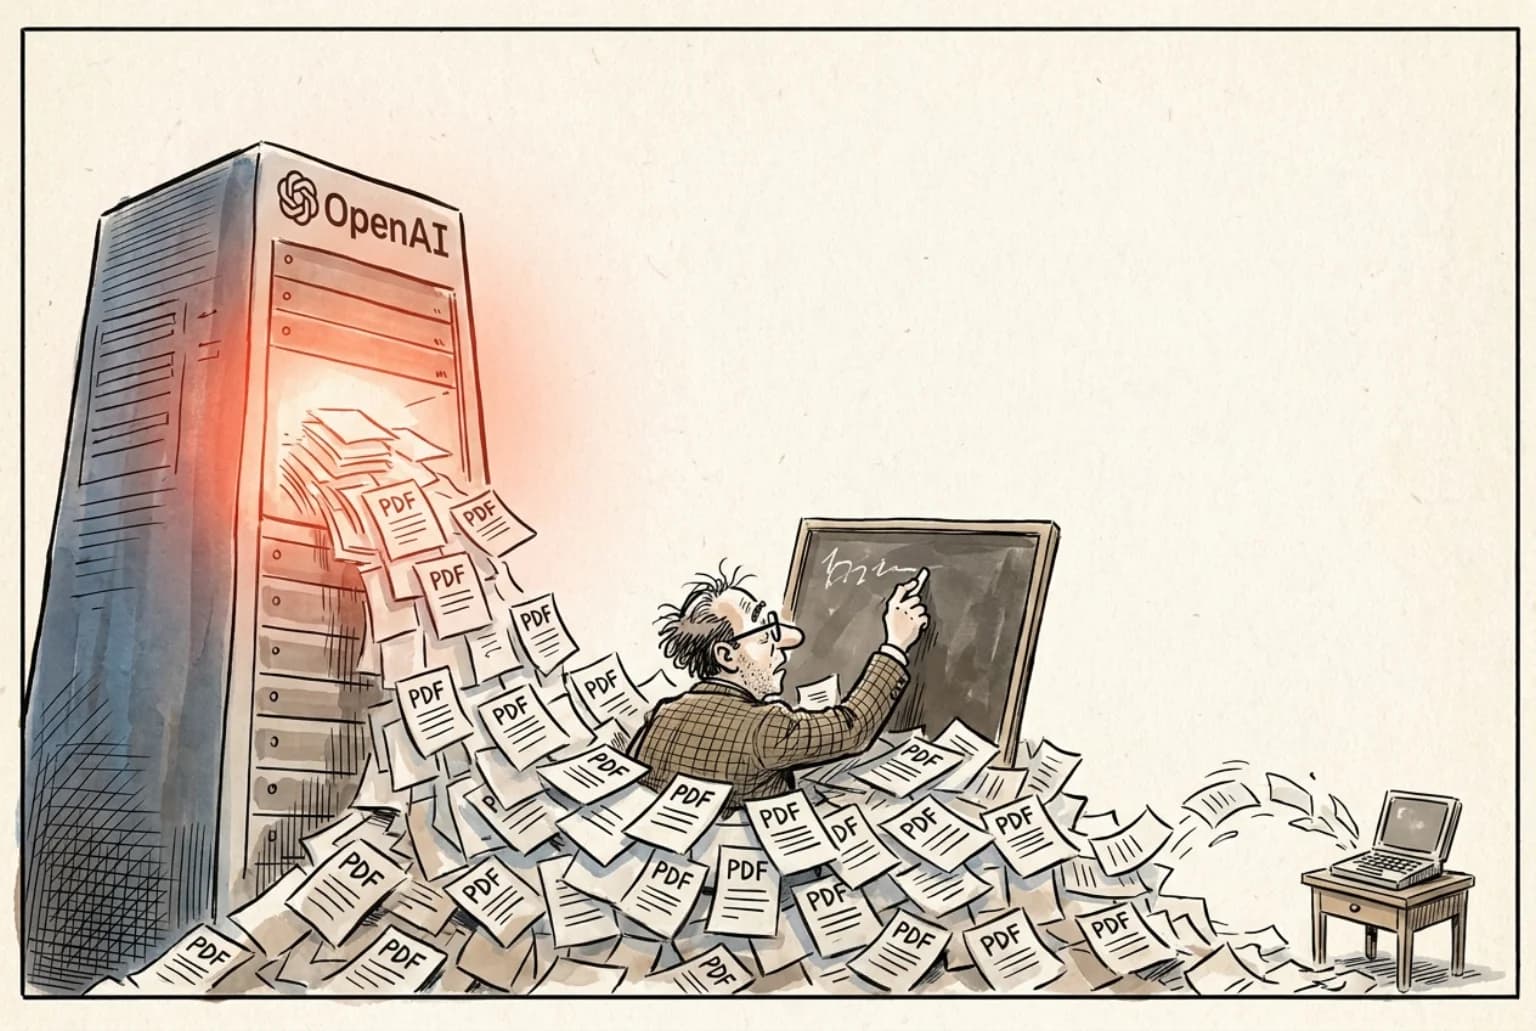
2026 年 9 月,OpenAI 在 GitHub 上公开了纳维–斯托克斯方程和欧拉方程有限时间爆破结果的 Lean 形式化证明;10 月 6 日,他们又一口气公开了 722 篇由内部模型完成的论文。这是一个属于顶尖人类大脑和庞大算力集群的领域。我也公开了一批数学成果。这批成果是 Claude 在我的笔记本电脑上花几个小时算出来的——我全程只发了几条 prompt,直到写完这篇文章,我都不太清楚这个数学问题本身是什么。而讲这件事的这篇文章,也就是你正在读的这篇,我和 AI 来回改了很多轮,出了好几个版本。一个巨大的反差摆在面前:让 AI 去算数学显得顺理成章,而让它老老实实写完一篇几千字的文章,却成了一场拉锯战。
在 2026 年,用 AI 刷数学纪录已经是一件很日常的事,这是我早就知道的。Claude 这次挑中的目标,在 Erich Friedman 的网站上。Friedman 是一位数学家,曾在美国 Stetson 大学当了 26 年的数学教授,2018 年退休后便专注趣味数学。他维护着一个叫 Packing Center 的网站,上面收录了上百个几何装箱问题。这些问题探讨怎么把若干个圆、正方形或多边形放进容器,或者在空间里摆点,要求最省空间或最均匀。每个问题都按规模列出目前已知最好的摆法,旁边标注着发现者的名字。如果有谁找到了更好的摆法,页面上的名字就会被替换掉。这些网页更新,由 Friedman 本人根据收到的投稿邮件手动完成。
Claude 找到的是一个关于在三维空间里摆点的问题。页面上的表格停在 30 个点,但规则允许扩展到 50 个点。31 到 50 这 20 个格子,从没有人填过。选这个问题有两个理由。一是没人注意到这一页。二是这个问题技术难度低,数学价值也低,没人愿意把时间花在这上面。Claude 填上这 20 个格子,就像是在一个被遗忘的角落里扫了一遍盲区。
数学计算这边的进展异常顺利。在那个世界里,每一步都有明确的对错。9 月 28 日开始,Claude 在我的笔记本电脑上跑了 4 个核,只用 5 分半钟就复现了表格上已有的最好结果。正式计算的第一轮跑了大约 5 个小时,夜里电脑重启,结果丢了。重算花了大约 7 个半小时。到了 9 月 29 日上午,全部 20 个结果就都出来了。
这 20 个结果里的每一个数字,都用分数精确验证过。数学的验证是严密的,不需要人去干预。为了保险,我问 Claude 结果有没有问题,它另开了一个看不到代码的独立 AI 审查了一遍。这个审查程序不需要理解 Claude 的推导过程,它只需要拿到最终的坐标,核对距离。它抓到了一个格式错误:最后一位全报高了。修改之后,9 月 29 日当天,我把结果从自己的邮箱投给了 Friedman,署名 Limin Ge。代码和结果后来也开源到了 GitHub。现在,这 20 个格子正在等待收录。
事情到这里本来就该结束了。数字能精确复算,独立审查能查出错误,机器在有明确规则的领域里游刃有余。可是,当我试图把这个过程写成一篇文章时,麻烦才刚刚开始。
9 月 29 日,我让 Claude 写了第一版稿子,它自己又做了一次去 AI 味的润色,读起来依然满是一股机器生成的味道。
我转头去找了 Gemini。我调用了它的 4 个模型,设定了 5 个不同的角度,让它们各写一篇,一共生成了 20 篇草稿。我原本指望不同的模型和不同的提示词,能碰撞出一些差异化的表达。读完这 20 篇文章,我的感觉是千篇一律,每一篇都有瑕疵。数字有明确的对错,也能被另一台机器复算。但一篇表达观点和经历的文字,没有标准答案。当面临这种没有标准答案的任务时,模型就会顺着训练数据的惯性,往最平均、最安全的说法上靠拢。它们生成了一堆挑不出语法错误,但读起来让人觉得乏味的段落。机器在文字的世界里只追求一件事:不出错的平庸。
事实错误反而是这些稿子里最容易解决的问题。把 20 篇草稿交给另一个 AI 去核查,它发现只有 1 篇没有编造或写错。在那些凭空捏造的情节里,模型把周一写成“周末”,加入“早上起来发现数据没了”的戏剧性描写,甚至把我从没说过的话塞进引号。数学结果有独立审查程序来兜底,因为坐标的距离有精确的数值。文字里的编造虽然也能被另一个程序揪出来,但它暴露了模型真正的运作方式:它不知道什么是事实,它只知道在人类的文章里,数据丢失通常发生在早晨,主人公往往会在这个时候发表几句感慨。
为了改稿,我专门做了一个工具。传统的对话框修改往往牵一发动全身,让模型重写一段,它可能会把整篇文章的语气都改掉。我的工具把修改限制在局部:我在网页上划掉不喜欢的句子,写一句批注,模型只重写被划掉的段落。到 10 月 8 日,我一共划了 4 轮,分别是 12 处、8 处、9 处和 4 处,前前后后出了 7 个版本。
有了这个局部重写的工具,修改过程依然充满阻力。我有时在批注里写明了要换成哪句话,模型照样改成别的表达。我前一轮划掉的词,过了一轮又被它若无其事地写了回来。它似乎对某些特定的词汇和句式有着执念。一旦脱离了精确的数学约束,它就开始在文字的概率网格里游荡,用它认为更合适的词汇替换掉我的表达。最后我只好定下一条规矩:凡是我写的话,一字不改地用。我只能用这种方式保护自己的耐心。
这是一种充满荒谬感的对照。我和成千上万的人一样,每天坐在屏幕前,试图用各种工具和规矩,跟一个语言模型的写作习惯较劲。大家以为把 AI 投入科研,是在拓展人类认知的边界。实际情况却是,那些能被精确验证的事,机器已经可以自己跑完所有流程。而最消耗人的,是那些没法量化的事。我花掉的时间,不是在核对事实——这件事有另一个 AI 做得更好——而是在跟模型争论一句话的写法,一个词的语感,对抗它那套由统计概率决定的平庸。当几十个无人在意的表格空缺都被机器填满时,人留给自己的工作,是在 AI 的帮助下,让 AI 的工作显得不那么像 AI 的产出。
- OpenAI 原文:Sharing AI progress in mathematics · github.com/openai/math
- 页面:Erich Friedman, Minimizing the Ratio of Maximum to Minimum Distance in 3 Dimensions
- 代码与结果:github.com/Ge-limin/maxmin3-records
- 状态:2026-09-29 已投稿,等待收录
订阅文章更新
有新文章时发一封邮件,仅此而已。